Proxmox VE — практическо ръководство
Част 7: Бекъп стратегия в Proxmox — vzdump, PBS и режим 3-2-1
Всичко друго в тази серия — ZFS, мостите, VLAN-ите, контейнерите — защитава системата, докато работи. Бекъпът е единственият инструмент, който работи, след като вече не е работила. Затова го правя скучен, автоматичен и проверяван по разписание, а не по настроение.
ℹ Бележка Командите са за Proxmox VE 8.x. Принципите важат и за една нода вкъщи, и за три в rack — меня се само мащабът, не логиката.
1. Режимът 3-2-1 — скучен, защото работи
Класическото правило е: 3 копия от всичко важно, на 2 различни медии, като 1 е извън обекта. Не е модерно, не е ново — просто нищо по-добро не е измислено. В моята лаборатория веригата изглежда така:
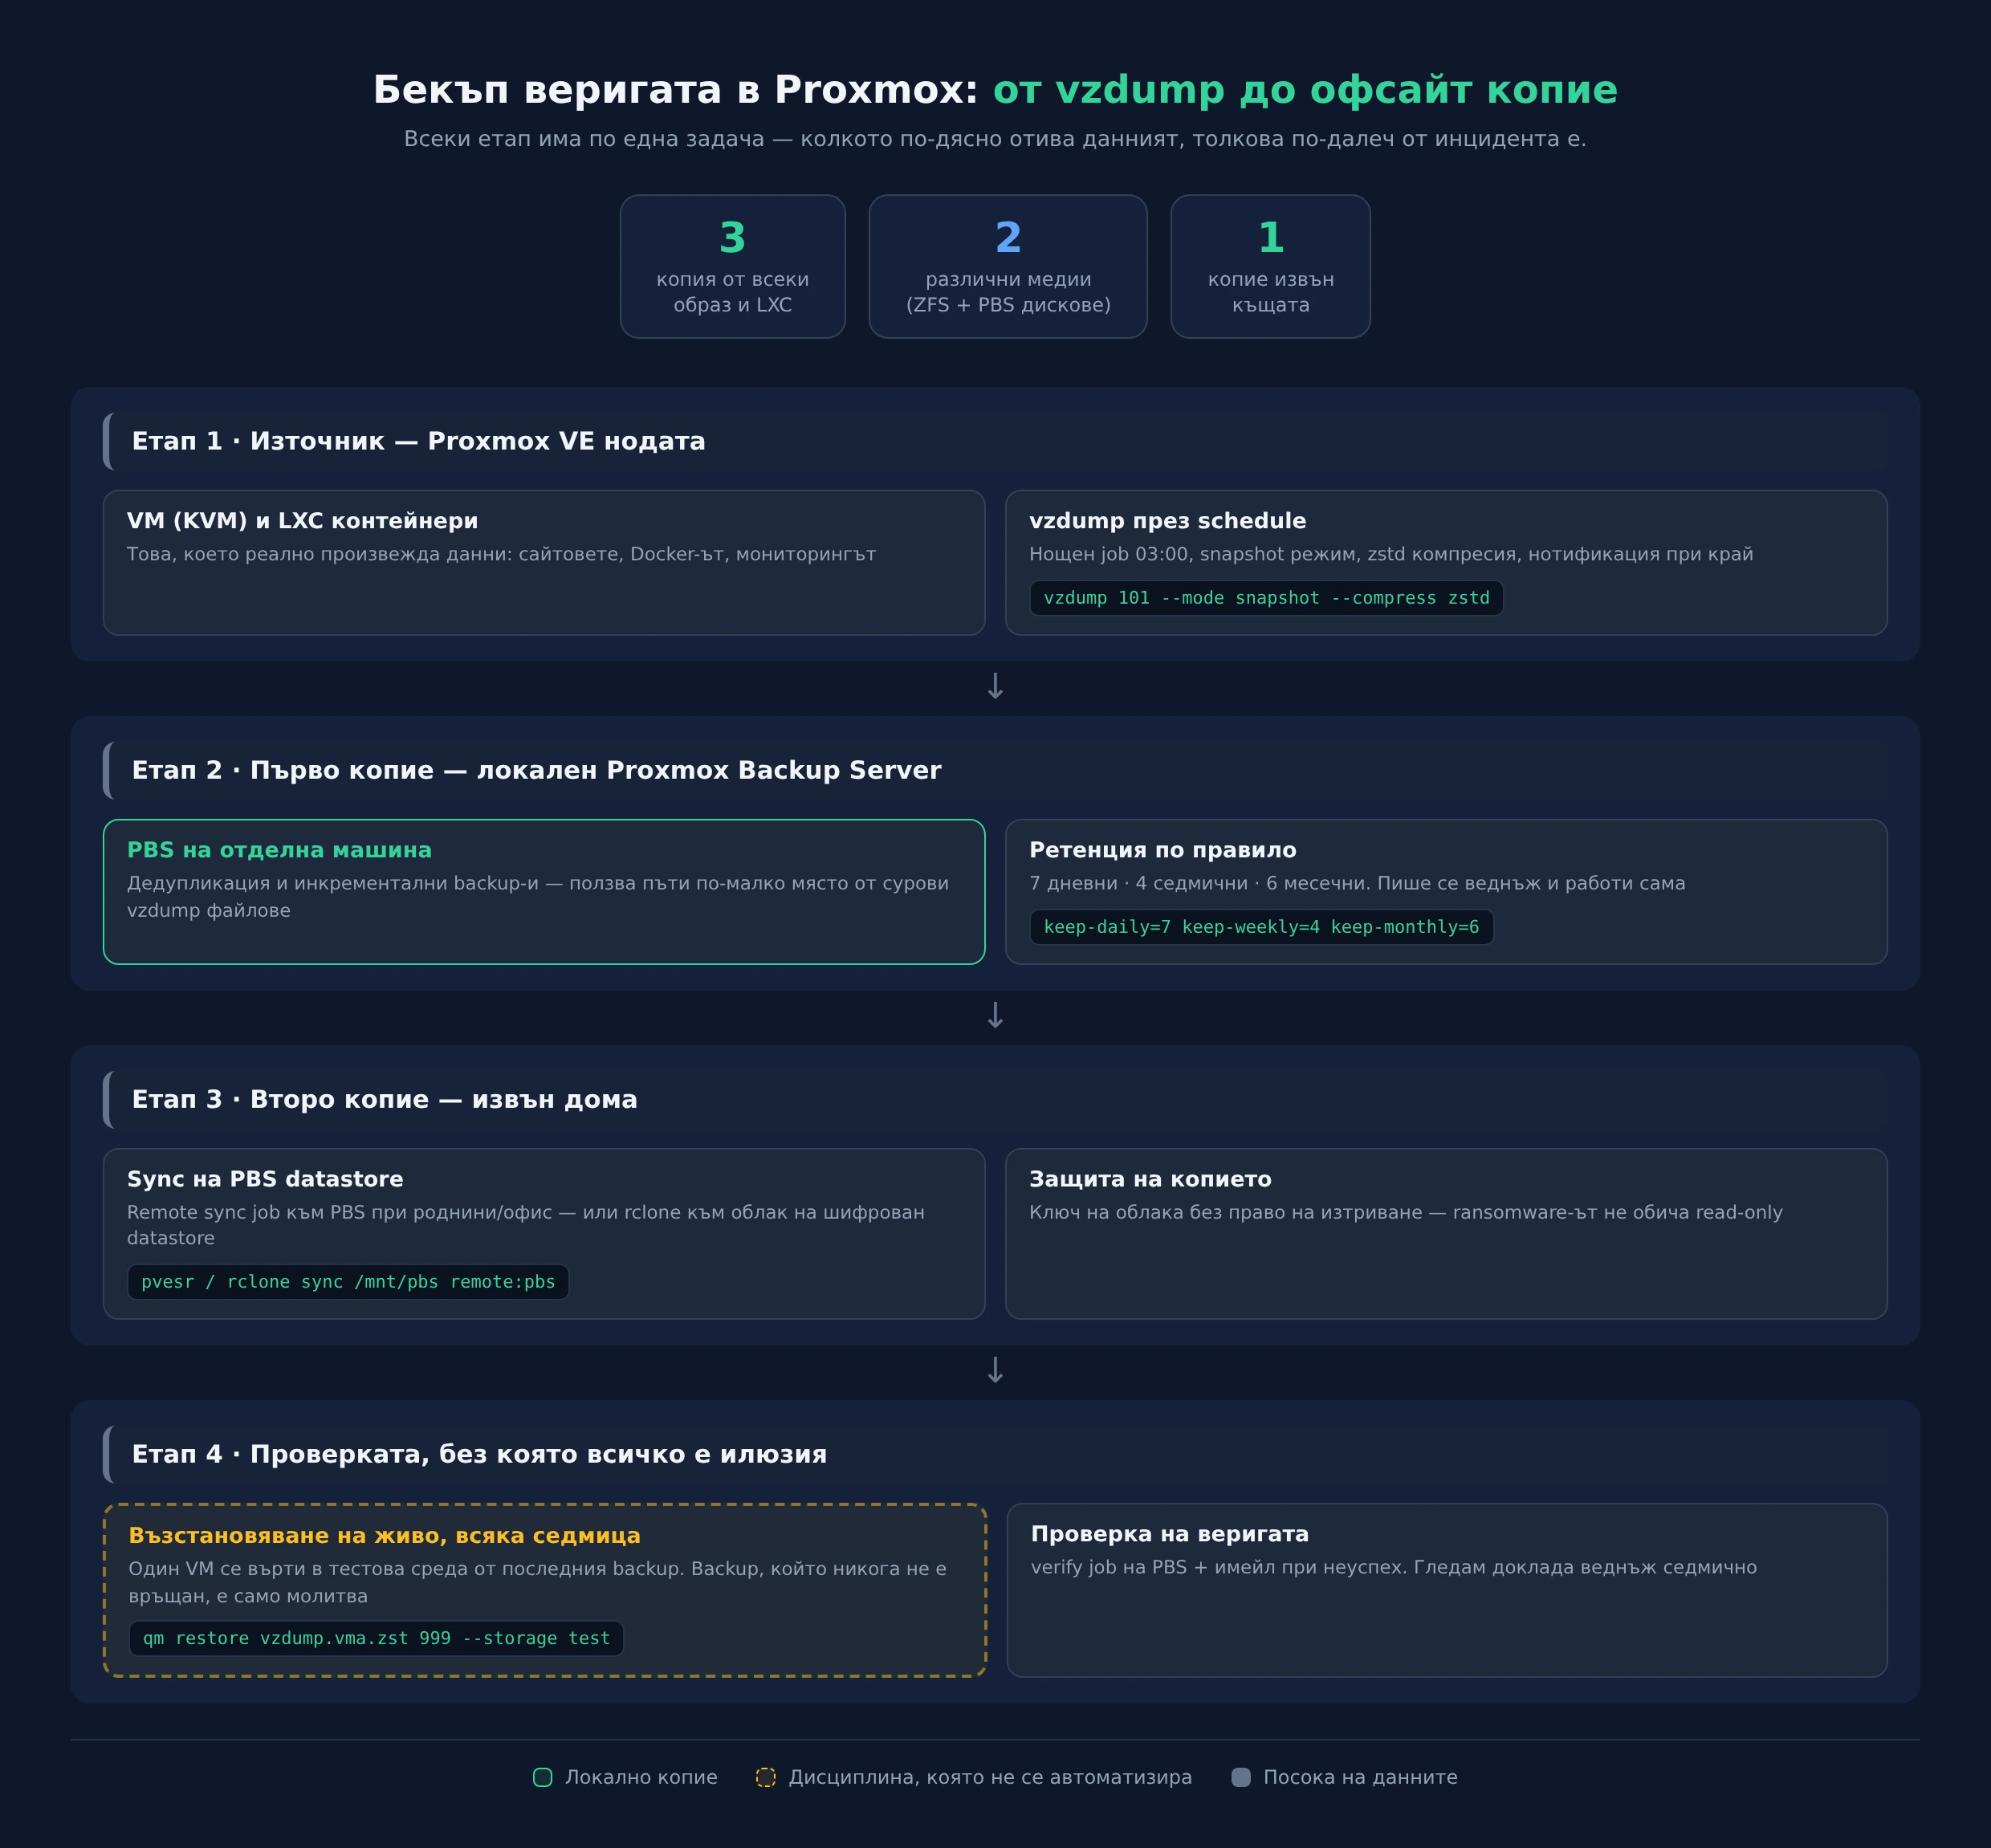
Четирите етапа от схемата са и структурата на тази статия.
2. vzdump — първото копие
vzdump е вградената утилита на Proxmox. Прави консистентен snapshot на VM (KVM) или LXC контейнер и го пакети. Три режима съществуват и разликата е важна:
| Режим | Как работи | Кога го ползвам |
|---|---|---|
snapshot | Записва в момента, без да спира VM (изисква QEMU agent / ZFS) | По подразбиране — денонощните услуги не пауза |
suspend | Замразява за няколко секунди | Съмнителни услуги без agent |
stop | Изключва напълно | Системи, които мразят hot-snapshot |
Нощният ми job е snapshot с zstd компресия — баланс между CPU и място:
vzdump 101 --mode snapshot --compress zstd --storage pbs --notes-template '{{guestname}}'Но ръчните бекъпи са за промени. Редовният поток иде от Datacenter → Backup schedule (нощта, 03:00) с ретенция. За ретенцията пазя:
keep-daily=7
keep-weekly=4
keep-monthly=6
⚠ Предупреждение Ретенция без проверено място е само wishlist. Първо изчисли колко заема един пълен бекъп × колко копия, после задавай числата. Иначе storage-ът се пълни нощем и backup-ите започват да се провалят тихо.
3. Proxmox Backup Server — второто ниво
Първата ми версия беше „vzdump файлове на NFS share”. Работи, но има два проблема: всяко копие е пълно по размер и всеки път се качват гигабайти.
PBS (Proxmox Backup Server) обърна това: дедупликация на блоково ниво + инкременталност. В практиката: след първия пълен бекъп, всеки следващ качва само промените. Мястото падна няколко пъти, времето на job-а — също.
Възможности, заради които PBS е отделна машина в моето setup:
- Дедупликация — общите блокове между VM-ите се пазят веднъж.
- Инкрементални вериги — история без пълни копия всяка вечер.
- Verify job — PBS сам проверява данните си по разписание.
- Енкрипция на клиента — ключът живее при мен, не в хранилището.
- File-level restore — изтеглям един файл от бекъп на VM, без да я възстановявам цяла.
Инсталацията е отделна тема (PBS е отделна дистрибуция) — тук записвам само клиентската страна, тоест какво се добавя в Proxmox VE:
pvesm add pbs pbs-local --server 192.168.1.20 --datastore main --fingerprint <PBS_FP> --password <API_KEY>4. Офсайт — копие, което пожарът не намира
Локалният PBS е чудесен за бърз restore след грешен rm. Но ако злополуката е на
ниво „запали се UPS-ът”, локалните копия изгарят заедно с проблема. Затова третият
етап е sync на datastore-а извън къщата.
Два практични пътя:
- Втори PBS на друга локация (роднини, офис) и PBS Remote Sync job между тях — дедупликацията работи и там, трафикът е минимален.
- rclone към облак на шифрован datastore — по-евтино начало, по-бавно възстановяване.
Важното нещо в двата случая: ключът да не е с право на изтриване. Ransomware с достъп до локалната мрежа обича и облачните копия — read-only код за достъп е разликата между „неприятно” и „безвъзвратно”.
5. Възстановяването — частта, която всъщност се плати
Бекъпът няма стойност, докато не е връщан. Моето разписание е просто:
qm restore /mnt/pbs/dumps/vzdump-qemu-101.vma.zst 999 --storage test --uniqueVM 999 е тестова инстанция — повдигам я, чупя я и я изтривам. Целта не е да е красиво, а да знам че веригата реално връща данни. Освен това PBS verify job тича седмично и изпраща доклад.
✓ Успех Моето правило: бекъп, който никога не е бил възстановяван, не е бекъп — това е молитва със schedule.
6. Какво НЕ е бекъп (и често се брои за такъв)
Три неща, които виждам да се бъркат постоянно:
- Snapshot не е бекъп. Живее на същия storage, при мъртъв диск умира с данните.
- RAID не е бекъп. Зат ни пази от фалирал диск, не от изтрит файл, вирус или повредено обновяване на pool-а.
- Репликация не е бекъп. Изтритият файл се репликира точно така, както се репликира запазеният.
Всичките три са полезни за достъпност. Бекъпът пази данните — двете не са едно и също.
7. Мониторинг на веригата
Бекъп, който се проваля тихо, е по-лош от липсващ — носи фалшив комфорт. Затова:
- Email при всеки job (успех и провал) — в Datacenter → Notification.
- Седмичен доклад от PBS — verify статус, заетост, възраст на последните копия.
- Едно поглеждане на доклада — всяка неделя гледам доклада, докато пия кафето. Пет минути, които са стрували вече поне един инцидент.
8. Командите накратко
| Команда | За какво я използвам |
|---|---|
vzdump 101 --mode snapshot --compress zstd | Ръчен бекъп при промяна. |
pvesm add pbs ... | Добавям PBS datastore като storage. |
qm restore FILE 999 --storage test | Възстановяване в тестова VM. |
pct restore FILE 999 --storage test | Същото за LXC контейнер. |
pvesm status | Виждам storage-ите и заетостта им. |
cat /etc/pve/jobs.cfg | Проверявам schedule job-овете като текст. |
proxmox-backup-client backup ... | Бекъп на файлово ниво отвън на нодата. |
rclone sync /mnt/pbs remote:pbs | Офсайт sync на datastore. |
9. Заключение
Бекъп веригата в Proxmox не е една настройка, а четири етапа: vzdump от нодата, PBS с дедупликация за историята, офсайт копие за катастрофите и тест на възстановяване за истината. Първите три се настройват веднъж; четвъртият е седмична привичка, която не може да се делегира на софтуер.
✓ Успех Моят принцип: не бекъпвам, за да спя спокойно — бекъпвам, за да съм върнал системата до обяд, преди да съм се опитал да обясня какво се е случило.